
О чём статья. Детектор автоответчика за первые пять секунд определяет по ритму речи, кто ответил на звонок: человек или голосовая почта. Он слушает только вызываемого абонента, замечает длину первой фразы и паузы и сбрасывает звонок, если это автоответчик. В исследовании на английских записях точность составила 96,1%. На 77 000 реальных звонков время на звонок с автоответчиком сократилось с 30 до 5,05 секунды (−83%), а экономия достигла около 13 300 минут работы ИИ-агента. Для автообзвона это означает, что время уходит на живых клиентов.
Детектор автоответчика — функция системы обзвона, которая в первые секунды звонка определяет, кто ответил: человек или голосовая почта. Если ответил человек, система соединяет его с оператором или запускает голосового ИИ-робота. Если автоответчик, она завершает звонок и может поставить номер на повторный обзвон. Так время уходит на разговоры с живыми людьми, а не на прослушивание записей.
Зачем нужен детектор автоответчика
Не каждый ответ на звонок превращается в разговор — иногда на линии голосовая почта или личный автоответчик. Живого человека там нет, а время идёт.
Детектор помогает отделить записи от живых ответов. Что это даёт:
- Оператору: в режиме предиктивного обзвона система сама набирает номера и соединяет оператора только с тем, кто ответил. Детектор следит, чтобы это был человек, и оператор не слушает чужие приветствия.
- Голосовому ИИ-роботу: запускает сценарий, когда ответил человек, и не тратит время на запись.
- Базе номеров: номер, на котором ответила запись, остаётся в работе: система позвонит на него позже.
Как система понимает, кто ответил
Вы сами за секунду слышите в трубке, что отвечает автоответчик. Система делает то же самое, но считает: она слушает первые секунды ответа и смотрит не на слова, а на ритм речи. Три признака дают больше всего:
- Как речь распределена по времени. Запись заполняет отрезок ровно: приветствие идёт без остановок. Человек отвечает коротко, и его речь сосредоточена в одном месте, чаще всего в начале.
- Длина первой фразы. Человек говорит «Алло» или «Слушаю». Автоответчик читает приветствие целиком.
- Пауза до первого слова. После соединения у записи она короткая и предсказуемая: линия переключается, и запись сразу начинает говорить.
Системы также ищут слова вроде «оставьте сообщение после сигнала» и ждут звукового сигнала после приветствия. В реальном времени эти способы дают меньше, о причинах ниже.
Как развивались алгоритмы распознавания
Первые системы работали по простым правилам: если первая фраза длится дольше заданного времени, это автоответчик. Такие правила понятны и быстро настраиваются. Другой распространённый способ — ждать гудка начала записи. Он звучит уже после приветствия, поэтому решение приходит через 10–30 секунд.
Следующий шаг — перевод начала разговора в текст и поиск типичных фраз автоответчиков. Метод точен, но медленнее и требует технического оснащения, а также слепков — образцов автоответчиков.
Современные модели изучают ритм речи: манеру говорить, произношение, паузы между словами. Модель обучается на тысячах записей и сама находит различия, которые трудно описать правилом. Такую модель проверили в исследовании 2026 года на англоязычных телефонных записях.
Что показало исследование
Главное:
- 96,1% записей определено верно: 734 из 764 на проверочных выборках.
- 5,05 секунды проходит от соединения до решения. Само вычисление занимает 46 мс на обычном процессоре без видеокарты.
- 41,6% из 77 000 реальных звонков система определила как автоответчики.
- −83% — длительность звонка на автоответчик. Ранее такой звонок занимал 30 секунд, теперь 5,05 секунды.
Как проводили проверку
Автор исследования проверял систему на записях настоящих телефонных звонков на английском языке.
Что «слушает» система. Только того, кто ответил на звонок: человека или автоответчик. Слова она не разбирает, а замечает, когда на линии говорят и когда пауза. По этому ритму она считает, например, как долго длится фраза, какие паузы между фразами и сколько секунд проходит до первого слова.
Кто принимает решение. Небольшая быстрая модель: 50 коротких цепочек вопросов «да или нет», в каждой не больше двух шагов. Автор перебрал около 3 780 вариантов настройки: разные модели, уровни чувствительности, время наблюдения за ответом (3, 5 и 7 секунд) и наборы признаков ритма. Затем выбрал лучший.
На чём обучали. На 24 812 записях реального обзвона. Какие из них автоответчики, определила другая программа, которая слышит обе стороны разговора. Автор проверил её разметку: примерно в 90% случаев она верна.
Как проверяли. Взяли две отдельные выборки записей.
- Первая: 140 записей, 70 автоответчиков и 70 живых ответов. Каждую вручную разметил эксперт.
- Вторая: 624 записи, 434 автоответчика и 190 живых ответов. Их не использовали при обучении. У 41% записей ответ проверили эксперты, у остальных 59% — программы, которые анализируют и звук, и расшифровку. Ещё 35 записей, где нельзя было однозначно понять, кто ответил, исключили.
Какие критерии важны при проверке ритма речи
Система смотрит на 15 свойств ритма речи, но почти всё решают три. Главная из них — как речь распределена по первым пяти секундам: на неё приходится больше половины вклада в решение (54,6%).
Дальше идут длина первой фразы (20%) и пауза до первого слова (11%). Вместе эти три признаки составляют 85,6%. Остальные 14,4% делят между собой остальные двенадцать критериев.
Сравнение с другими способами
На одних и тех же записях автор сравнил свой метод с расшифровкой речи и с определением по гудку. Классические правила по паузам он на этих записях не проверял: это правила, которые по длительности первой фразы и пауз решают, кто ответил: человек или автоответчик.
Расшифровка речи точнее ритма: 97,6% против 96,1%. Система переводит начало разговора в текст и ищет фразы вроде «оставьте сообщение». Но у способа есть цена: расчёт длится в 10 раз больше времени, и необходимо техническое оснащение.
Исследователь считает расшифровку подходящей для разбора записей после звонка или как запасной вариант. Основным способом для живого звонка он выбирает ритм.
Вы можете расшифровать и автоматически проанализировать записи разговоров с клиентами с помощью речевой аналитики в сервисе «Скорозвон». Вы получите рабочие бизнес-инсайты: оценку звонков, персональные ИИ-рекомендации и скрытые возражения.
Определение по звуковому сигналу оказалось почти бесполезным: точность составила всего 50,7%. У этого способа три слабых места:
- Гудок звучит после приветствия, поэтому решение приходит через 10–30 секунд, когда время уже потрачено.
- Многие современные автоответчики вообще не дают стандартного гудка.
- На канале вызываемого абонента гудок почти не слышен, а фоновый шум даёт 23,2% ложных срабатываний.
Классические правила по паузам. Определение по паузам и длине приветствия встроено в большинство телефонных платформ. Автор исследования не проверял его на своих записях, поэтому прямого сравнения по точности нет.
Границы применимости
Язык. Все записи были на английском, другие языки автор не проверял. По его оценке, приёмы от языка не зависят, но приветствия различаются по культурам. Например, в японском они длиннее.
Разметка для обучения. Метки в обучающей выборке поставила другая программа, а не люди. Поэтому редкие случаи, в которых она ошибалась, могут оказаться слепой зоной для самой системы.
Короткие приветствия. Если приветствие короче примерно трёх секунд, сигнала для решения не хватает. Для таких случаев автор предлагает запасную модель, которой достаточно трёх секунд.
Сколько времени освобождает детектор
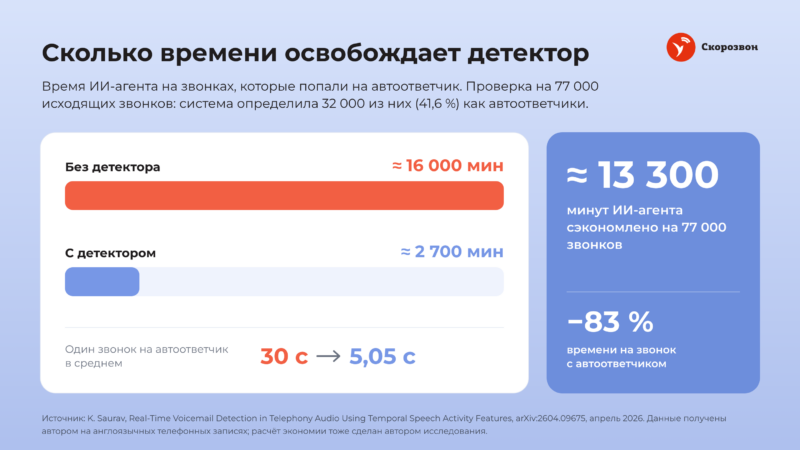
По данным исследования, звонок на автоответчик без детектора длится в среднем 30 секунд, с детектором — 5,05 секунды. На 77 000 звонков это выглядит так:
Как настроить обзвон с детектором автоответчика: 4 шага
- Решите, что делать с автоответчиком. Самый простой вариант: завершить звонок и перенести номер на повторный обзвон в другое время суток.
- Опишите сценарий для двух исходов. Ответил человек: начинается разговор. Ответила запись: звонок завершается. Голосовой ИИ-робот Скорозвона работает по гибкому сценарию, поэтому оба исхода описываются в одном сценарии обзвона.
- Следите за результатом. Сравните долю автоответчиков в вашей базе с 41,6% из исследования. Посмотрите, сколько ответивших людей дошло до разговора и сколько минут освободилось по сравнению с прошлой неделей.
- Разбирайте разговоры. Речевая аналитика Скорозвона переводит звонки в текст и оценивает диалоги по смыслу, поэтому вы видите, как проходили разговоры с теми, кто ответил, и что стоит поправить в сценарии.